手机相册里翻到一张猫的照片,它能自动把这张归进"猫"的相册。工厂摄像头能一眼看出焊缝上有一条裂纹。语音助手能把你说的话原样变成文字。
这些本事看着像机器天生就懂。可机器其实什么都不懂。
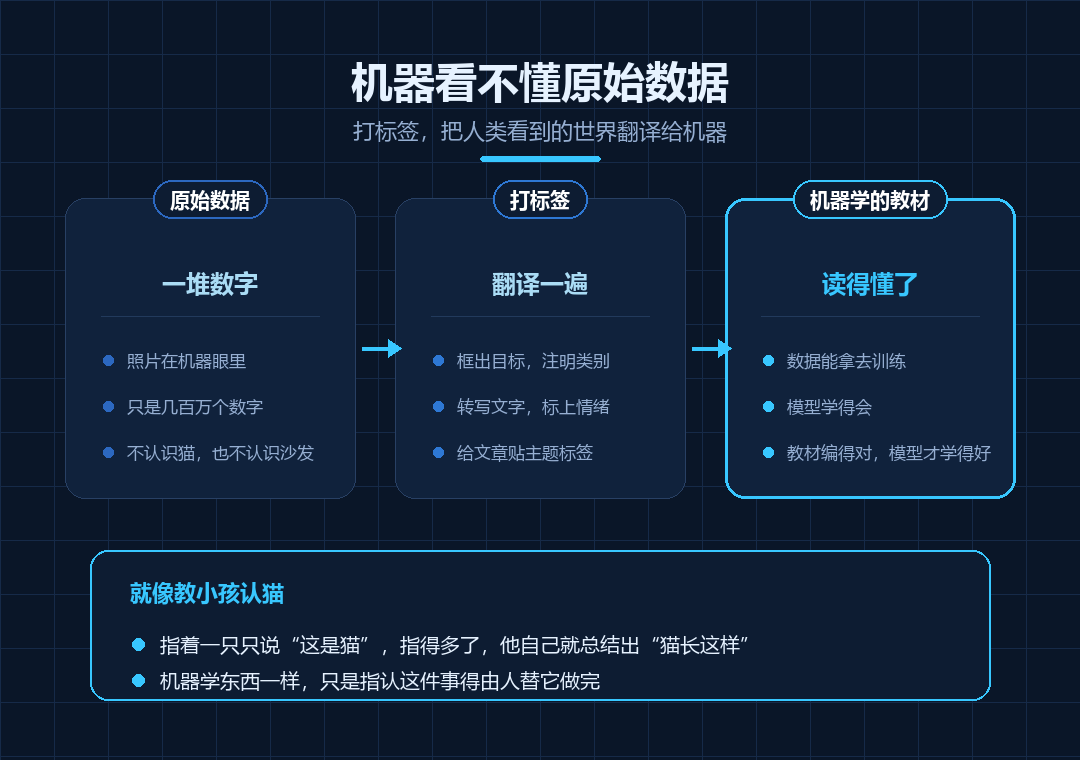
一张照片在模型眼里,是几百万个数字排成的格子,它不知道哪几个格子是猫耳朵、哪几个是背景里的沙发。一段录音在它眼里只是一条起伏的波形,说没说话、什么情绪,一概读不出来。
原始数据,机器是看不懂的。让人和机器之间能对上话的,是另一件事:数据标注。
01 打标签,就是把人类看到的世界翻译给机器
先想教小孩认猫。
你不会给他一本《猫的定义》让他自己悟。你会指着一只猫说"这是猫",再指一只说"这也是猫",指得多了,他自己就总结出"猫长这样"。机器学东西的路子一模一样,只是指认这件事,得由人替它做完。
这就是打标签。落到不同的数据上,样子不太一样:
- 图像标注,是在照片里框出目标,再注明它是什么类别;
- 语音标注,是把录音逐句转写成文字,再标上说话人是高兴还是生气;
- 文本标注,是给一篇文章贴上主题标签,比如"体育""科技"。
有人把数据叫做"新石油"。按这个说法,标注就是把原油炼成汽油的那道工艺:没有标签,数据只是堆在硬盘上的素材;有了标签,它才变成机器能用的教材。
02 一道标签,要走好几道关
听到"打标签",很多人的第一反应是这活没门槛。真做起来不是。
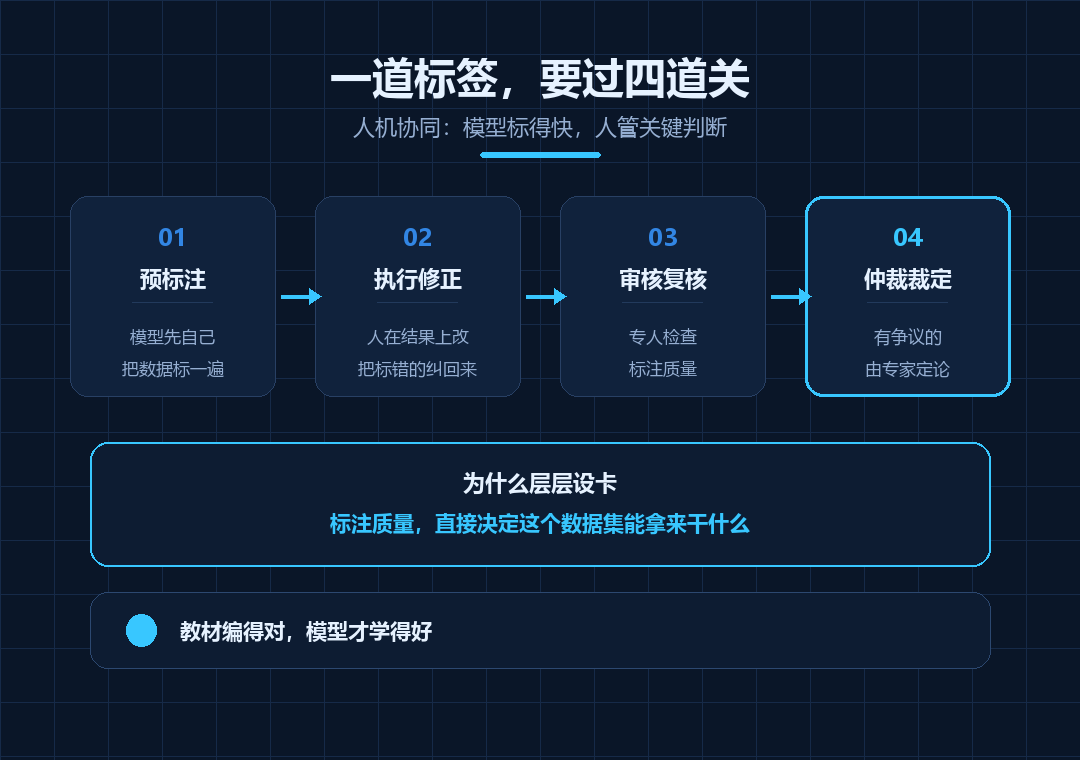
现在的主流做法叫"人机协同"。一批数据进来,先让模型自己标一遍,这叫预标注;人接着在预标注的结果上改,把模型标错的地方纠回来。人在这里干的是关键判断,不只是体力活。
标完还不算完。国家标准里,数据标注人员被分成执行、审核、仲裁、监督几类:执行人员产出标注结果,审核人员复核质量,双方有争议的,交给仲裁人员裁定。
为什么要层层设卡?因为标注的质量,直接决定这个数据集能拿来干什么。国家数据局给"高质量数据集"下的定义很直白:经过采集、加工等数据处理,可以直接拿去开发和训练人工智能模型,并且能有效提升模型表现的数据集合。标注,就是里面最关键的那道执行工序。
模型学得好不好,先看它拿到的教材编得对不对。
03 这不是小生意,账已经算出来了
据测算,2023 年我国数据标注产业规模约 800 亿元。
2024 年 12 月,国家发展改革委、国家数据局、财政部、人力资源社会保障部四部门联合印发《关于促进数据标注产业高质量发展的实施意见》。这是国家层面第一次专门为这条产业链做系统谋划,文件把数据标注产业定义为"对数据进行筛选、清洗、分类、注释、标记和质量检验等加工处理的新兴产业",并给出目标:到 2027 年,产业规模大幅跃升,年均复合增长率超过 20%。
落地的抓手是基地。2024 年 5 月,首批国家级数据标注基地名单公布,成都、沈阳、合肥、长沙、海口、保定、大同 7 个城市承接建设任务。到 2025 年上半年,这 7 个基地已经建设数据集 524 个、服务大模型 163 个,带动的相关产值超过 83 亿元。
这些数字落到最具体的场景,是一件件很朴素的活:工厂里把产品缺陷的尺寸、位置、类型一个个标出来,电力现场把设备异常的样貌标出来。标得够多够准,模型才学得会"看一眼就知道不对"。机器的识别能力,很多是从人这里一点点喂进去的。
结语:模型的上限,先被数据定住了
回到开头那三个本事。
相册认猫、监控认裂纹、语音转文字,背后都站着同一件事:有人把原始数据一条条标过。模型再先进,这一步也跳不过去。
所以看人工智能,除了看算法和算力,还得往下看一层:喂给它的数据,是谁标的、怎么标的、标得认不认真。模型能力的上限,很多时候在数据进炉子的那一刻就已经定住了。
注:本文为数据要素科普系列第十三篇。文中《关于促进数据标注产业高质量发展的实施意见》为国家发展改革委、国家数据局、财政部、人力资源社会保障部四部门文件(2024 年 12 月印发);数据标注产业与高质量数据集的定义参见国家数据局《数据领域常用名词解释(第二批)》《高质量数据集建设指引》及国家标准 GB/T 42755-2023、GB/T 45674-2025;7 个数据标注基地成效数据据人民网 2025 年 10 月报道(引国家数据局有关负责人);产业规模 800 亿元为 2023 年测算值(央视网报道)。